

El día en que generar un vídeo costó menos que verlo
En abril de 2026, una demostración pública generó un clip de 5 segundos en 2,4 segundos. Por primera vez, un modelo de generación de vídeo con IA de uso general es capaz de producir imágenes más rápido de lo que tardamos en verlas. Fue con el modelo abierto Wan 2.2 sobre servidores de Tenstorrent.
Para quienes trabajamos en televisión, estas cifras empiezan a cambiar las reglas del juego, por no decir que lo cambia todo. Si producir un minuto lleva menos de un minuto, ya no hablamos de fabricar piezas: hablamos de emitir flujos. Canales que se generan sin fin, versiones a medida para cada espectador, continuidad que no se agota. Sin duda parece algo de ciencia ficción pero que ya es una realidad.
Pero no es oro todo lo que reluce por el momento, los modelos comerciales de máxima calidad todavía tardan minutos por clip y cuestan varios euros por minuto. Para entender dónde estamos, y hacia dónde vamos, merece la pena repasar cómo hemos llegado hasta aquí. Es un camino que he recorrido desde las primeras versiones de DALL·E 2, Midjourney y Stable Diffusion.
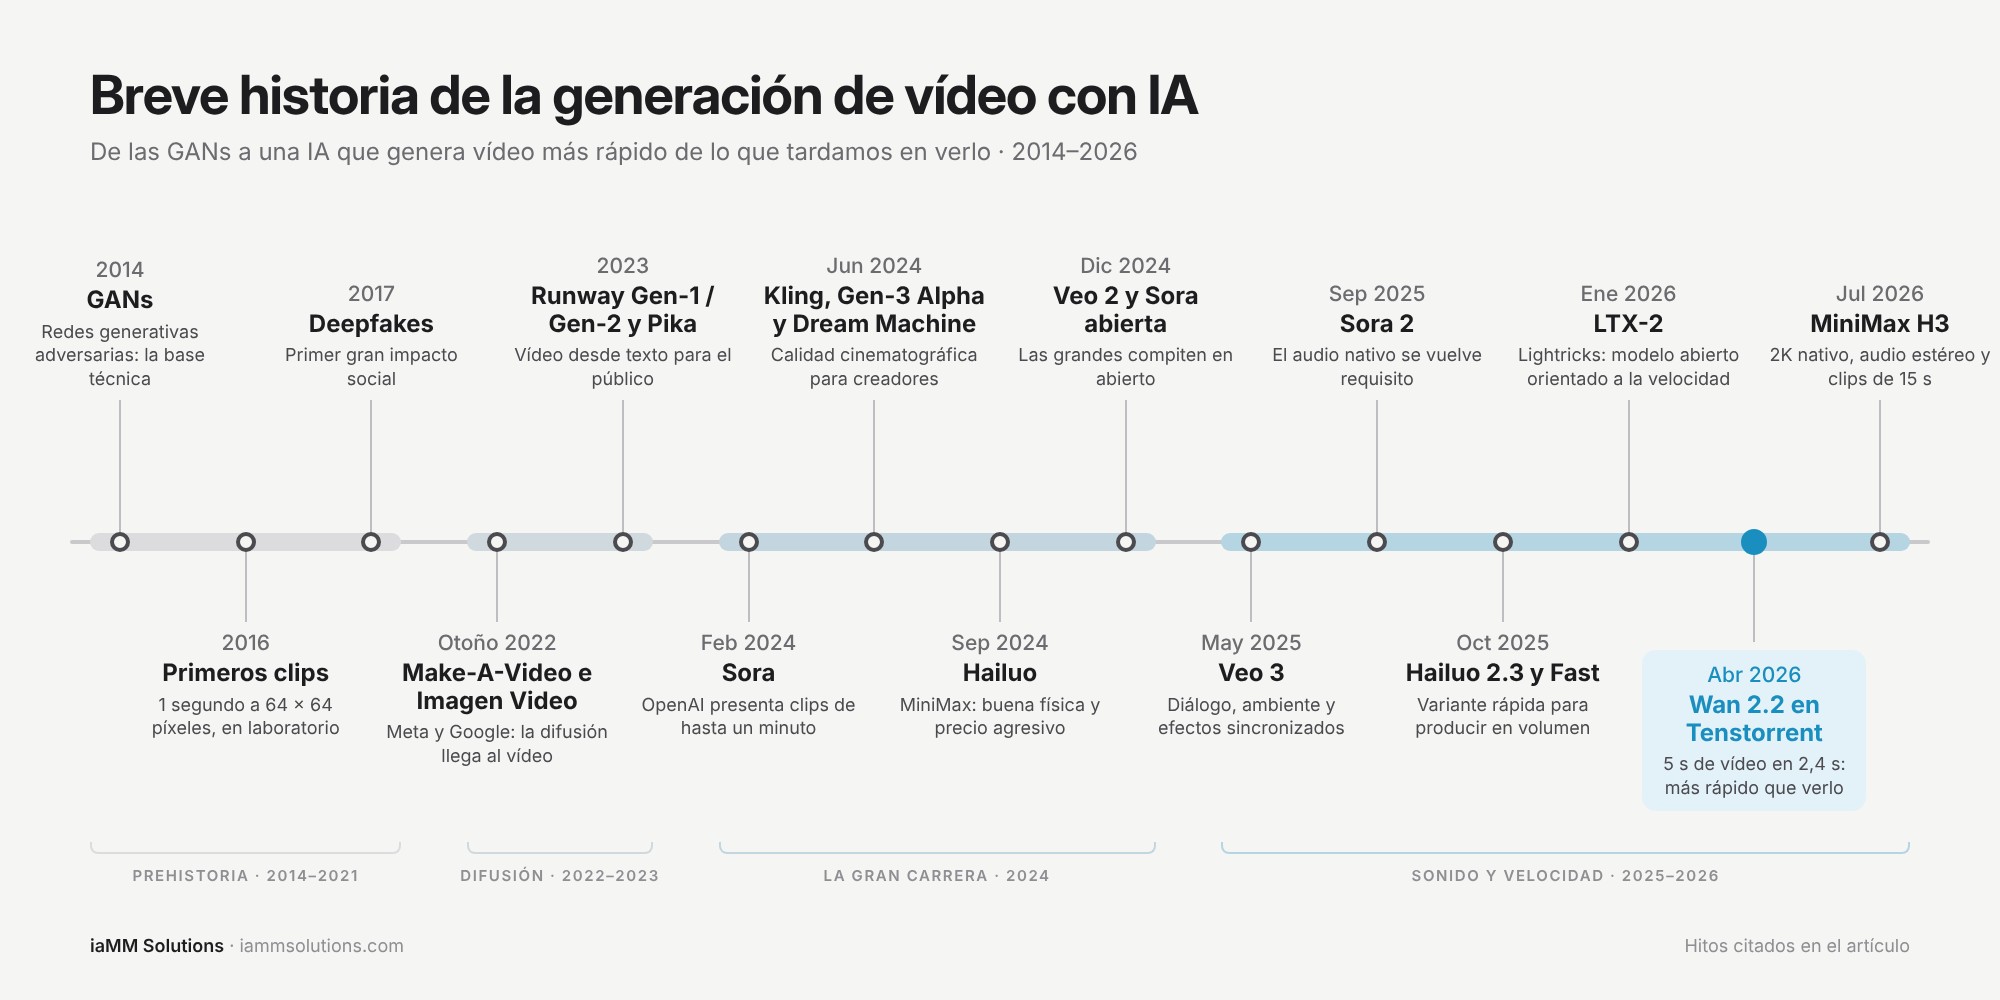
2014–2021: la prehistoria, entre GANs y deepfakes
Todo esto empezó con dos redes generativas adversarias, que son conocidas por sus siglas en inglés (GANs). Este tipo de pruebas eran puramente experimentales y se utilizaban apra generar los conocidos como pappers a nivel académico. ¿Cómo funcionaban? Su trabajo consistía en competir entre si, una inventa imágenes y otra intenta detectar las falsas. Con ese duelo, las máquinas aprendieron a crear caras y paisajes verosímiles.
Llevarlo al vídeo fue mucho más difícil. Los primeros experimentos académicos, hacia 2016, generaban clips de un segundo, a 64 x 64 píxeles, con movimientos que se deshacían en manchas. SI quieres profundizar más en el tema consulta la página oficial del MIT
El primer impacto social llegó en 2017 con los deepfakes. No creaban vídeo desde cero: sustituían una cara por otra sobre material existente. Aun así, abrieron dos debates que siguen vivos en cualquier redacción: la verificación de imágenes y el uso de la identidad ajena.
2022–2023: la difusión llega al vídeo
El salto vino de los modelos de difusión, la misma técnica que popularizaron DALL·E 2, Midjourney y Stable Diffusion en imagen, que fueron mis primeras andanzas con la ia generativa, se basaban en partir de ruido puro y lo iban «limpiando» paso a paso hasta que aparecía una imagen coherente con el texto. Hoy esa misma técnica es la base de herramientas de imagen como Nanobanana o Magnific.
En otoño de 2022, Meta presentó Make-A-Video y Google, Imagen Video. Eran demostraciones de laboratorio: clips de pocos segundos, sin acceso público, pero con algo nuevo. Por primera vez bastaba con escribir una frase para obtener movimiento. Y aquí se vio claramente hacia donde iba a ir este mundo.
En 2023 la tecnología salió del laboratorio y nace Runway que lanzó Gen-1, que transformaba vídeos existentes, y después Gen-2, que ya generaba desde texto. A final de año llegó Pika. Los clips duraban 3 o 4 segundos, deformaban manos y caras, y el movimiento parecía de plastilina, pero cualquiera podía probarlo desde el navegador.
2024: Sora y la gran carrera
En febrero de 2024, OpenAI enseñó Sora y boom todo el mundo se volvió loco. Clips de hasta un minuto, cámaras que se movían con lógica cinematográfica y escenas que mantenían la coherencia. El sector audiovisual entendió de golpe que aquello iba en serio. Esto ya empiezan a see palabra mayores.
Sora tardó meses en abrirse al público, y en ese hueco estalló la competencia:
- Kling (Kuaishou, junio): el primer gran modelo chino, con clips largos y movimiento realista.
- Runway Gen-3 Alpha y Luma Dream Machine (junio): calidad cinematográfica al alcance de creadores.
- Hailuo de MiniMax (septiembre): su primer modelo de vídeo destacó por la física de los movimientos y por un precio agresivo.
- Veo 2 de Google y la apertura de Sora (diciembre): el año cerró con las grandes tecnológicas compitiendo en abierto.
Al terminar 2024, generar 5 o 10 segundos de vídeo creíble era rutina. Seguía faltando algo esencial para la televisión: el sonido. Durante este tiempo probé todos los modelos, y tuve la suerte de conseguir un proyecto en el que encajaba este tipo de imágenes, Runway fue la que elegí y me lo pasé tan bien, y eso que alucinaba mucho, tenías que interactuar muchas veces hasta conseguir videos de una calidad profesional.
2025–2026: sonido, alta resolución y velocidad
En mayo de 2025, Veo 3 de Google generó por primera vez vídeo con diálogo, ambiente y efectos sincronizados. En septiembre llegó Sora 2. Desde entonces, el audio nativo es requisito, no extra. La velocidad de la salida de los nuevos modelos con nuevas funcionalidades y cada vez mejores empieza a ser tan rápido que da vértigo. Uno de los ejemplos más recientes es Grok Imagine Video 1.5 de xAI, que analizamos en este blog.
MiniMax siguió el ritmo. Lanzó Hailuo 2.3 en octubre de 2025, con una versión Fast pensada para producir en volumen (Hedra). En julio de 2026 presentó MiniMax H3: vídeo 2K nativo con sonido estéreo y clips de hasta 15 segundos.
Donde sí se ha roto la barrera
La generación más rápida que la reproducción ya existe, pero en otra liga eso sí. Tenstorrent generó 5 segundos de vídeo 720p en 2,4 segundos con Wan 2.2, usando 256 aceleradores (Wccftech). Lightricks lanzó LTX-2 en enero de 2026, orientado a la velocidad (MindStudio). Y en septiembre de 2026, Runway explicó cómo adapta sus modelos para producir vídeo en streaming mientras se escribe la instrucción (Runway).
Hoy se ven claramente dos carreras: la de la calidad, que se mide en minutos y euros por clip, y la del tiempo real, que ya va más rápido que el reloj.
Qué significa para la televisión y el audiovisual
Cuando la generación supera a la reproducción, el vídeo deja de ser un producto terminado y pasa a ser un flujo. Esto abre posibilidades que hace dos años eran ciencia ficción:
- Canales de creación infinita. Contenido ambiental, infantil o temático que se genera sin pausa y nunca se repite.
- Personalización a escala. Versiones de una misma pieza adaptadas por idioma, región o perfil del espectador.
- Previsualización instantánea. Guiones gráficos animados, pruebas de plano y propuestas creativas en minutos, no en días.
- Recursos de continuidad. Cortinillas, fondos, transiciones y grafismo animado generados bajo demanda.
Estas son algunas de las aplicaciones que se me ocurren y que en algunos casos ya son posibles de ver y probar.
Lo que todavía hay que resolver
Pero claro, la velocidad no lo es todo. Hay cuatro grandes escollos que quedan por salvar:
- Coste de la calidad. Un minuto en 2K con un modelo de primer nivel cuesta varios euros, y no todas las tomas sirven. Lo que importa es el coste por pieza aprovechable, no por segundo generado.
- Duración y coherencia. Los clips siguen siendo cortos. Mantener personajes y escenarios durante minutos exige encadenar y supervisar.
- Derechos y regulación. MiniMax, como otros, afronta demandas por derechos de autor. Las cadenas deben conocer el origen de cada imagen y cumplir las normas de etiquetado de contenido sintético.
- Criterio editorial. Generar es fácil; decidir qué se emite, no. La mirada profesional pasa de fabricar a dirigir y validar.
En mi opinión la conclusión para cualquier responsable técnico o de contenidos creo que es clara: no se trata de si la IA entrará en la cadena de producción, sino de en qué puntos y con qué controles. Pero que pueda hacer un articulo como este de una tecnología que se ha desarrollado en 10 años y que estamos en este nivel a octubre de 2026, empieza a ser muy importante para nuestro sector.
En IAMM Solutions ayudamos a televisiones y productoras a dar ese paso con criterio, desde la experiencia en realización y gestión de proyectos audiovisuales. Descubre Atlas Factory nuestra plataforma. Si quieres probarla o simplemente quieres hacernos llegar una duda o propuesta, escríbenos a info@iammsolutions.com estamos aquí para buscar las mejores soluciones para tu proyecto.
Evidentemente esto no es todo en detalle pero si un buen comienzo si quieres tener un poco de conocimiento de la evolución. Mientras escribía esto se me ha ocurrido probar con Claude un video, le he propuesto hacer una presentación con este promt: De minutos a segundos: breve historia de la generación de vídeo con IA, hecho con el modelo Opus 5.5.